






Ci si può fidare del progresso matematico di OpenAI? I matematici protestano

- Il 8 settembre OpenAI ha annunciato che un sistema AI interno ha risolto il Problema del Premio Millennium di Navier-Stokes.
- Da allora è stata accusata dai matematici Tristan Buckmaster e Levent Alpöge di aver affrettato i lavori dopo aver preso visione dei propri.
- L'azienda nega di aver acceduto ai dati, pur ammettendo di "non poter escludere" che dati d'uso de-identificati abbiano contribuito ad addestrare i suoi modelli.
OpenAI ha affermato di aver risolto il problema dell'esistenza e della regolarità di Navier-Stokes, uno dei sette Problemi del Millennio dichiarati dal Consiglio Scientifico Consultivo dell'Istituto di Matematica Clay di Cambridge, Massachusetts (CMI). Tuttavia, il problema più difficile da risolvere potrebbe essere convincere una galleria pubblica che è diventata sempre più scettica sui metodi del gigante dell'IA.
OpenAI è passata direttamente dalla risoluzione di uno dei problemi matematici irrisolti più difficili della nostra epoca alla risposta alle domande di due matematici che chiedevano se il loro lavoro non pubblicato avesse in qualche modo aiutato il laboratorio ad arrivare alla sua risposta.
Tuttavia, mentre questo dramma si svolge pubblicamente, OpenAI è indietro di qualche passo nella percezione, come previsto quando un laboratorio di IA dal valore di un trilione di dollari implicato in un hacking di sicurezza da parte di un agente autonomo e in un "bilancio di sicurezza" interno riguardo alla gestione del rischio si scontra con due accademici con cui è facile identificarsi.
Quale problema matematico ha appena risolto OpenAI?
Il laboratorio di IA guidato da Sam Altman ha affermato di aver scritto la prova e una versione verificabile dalla macchina nel linguaggio di dimostrazione Lean che un fluido liscio e inizialmente calmo può, sotto una forza liscia, accelerare senza limiti e degradarsi in tempo finito.
Il lavoro, che OpenAI afferma sia stato svolto da un modello interno più capace del suo recentemente rilasciato modello GPT-6 Astra, risolve uno dei sette problemi da un milione di dollari elencati dall'Istituto di Matematica Clay nel 2000.
OpenAI ha affermato di aver speso più per il conto di calcolo del premio di 1 milione di dollari offerto dal CMI, secondo il capo della ricerca Mark Chen. Sebastien Bubeck, un ricercatore del laboratorio, ha detto che circa 10.000 agenti stavano lavorando al problema in un dato momento.
L'Istituto Clay non ha ancora riconosciuto la prova di OpenAI. L'istituto richiede che le soluzioni siano pubblicate su una testata qualificata, siano disponibili al pubblico per due anni e ricevano un ampio accettazione da parte dei matematici prima di essere prese in considerazione per il premio.
È notevole che OpenAI abbia già detto che non cercherà il premio in denaro.
OpenAI ha utilizzato il lavoro dei matematici nei loro log di chat?
Il dibattito principale sul lavoro di OpenAI non riguarda nemmeno la matematica. Il vero dramma riguarda se le informazioni che Tristan Buckmaster della NYU e Levent Alpöge, un matematico impiegato da Anthropic, hanno alimentato nei modelli di IA, incluso il Codex di OpenAI, siano state dirottate.
Tristan ha chiesto direttamente ai ricercatori del laboratorio se le sue sessioni e quelle di Levent su Codex stessero venendo utilizzate quando ha sentito per la prima volta che il laboratorio di IA aveva indirizzato una grande capacità di calcolo verso la risoluzione del nodo Navier-Stokes.
Tipico di un matematico, Tristan si è astenuto dal fare accuse senza prove, scrivendo in un comunicato pubblico che "non so se i nostri dati siano stati utilizzati".
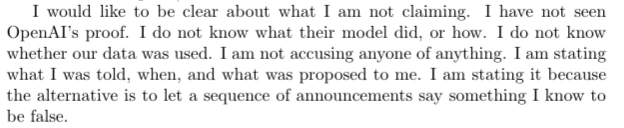
Tuttavia, lo stesso documento accusava OpenAI di avanzare "proposte" che includevano la rimozione del nome di Levent da un annuncio che attribuiva la soluzione al modello interno di OpenAI.
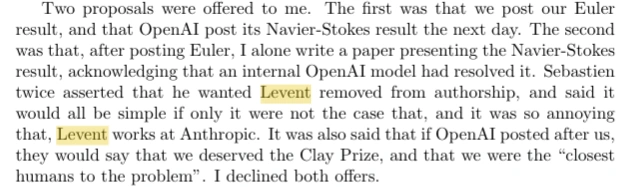
Bubeck ha da allora confutato quella affermazione, scrivendo su X: "Non ho mai chiesto che Levent fosse rimosso dalla paternità della sua opera", ha scritto.
Vorrei chiarire alcune cose:
1) La schermata è il mio tentativo di contattare Levent per coordinare i nostri rilasci. Spero sia chiaro dal messaggio che siamo intervenuti con le migliori intenzioni possibili.
2) Non ho mai chiesto che Levent fosse rimosso dalla paternità della sua opera... pic.twitter.com/yRli0hLNuM
— Sebastien Bubeck (@SebastienBubeck) September 8, 2026
Anche Sam Altman si è espresso per sostenere il suo team.
"Improbabile ma non impossibile" non è una negazione abbastanza forte per gli scettici
La difesa principale di OpenAI è netta: né le sue persone né i suoi agenti hanno visto i prompt, le bozze o i dati degli utenti della coppia, e hanno incontrato il lavoro solo una volta che è diventato pubblico.
Tuttavia, nel suo stesso post sul blog, la società ha aggiunto una riga che Lo stesso Levent ha segnalato: "Sebbene improbabile, non possiamo escludere che dati de-identificati derivanti dal loro utilizzo dei nostri prodotti abbiano contribuito a migliorare i nostri modelli."
"voglio dire, complimenti per averlo detto chiaramente","50":"Levent ha postato" Levent ha pubblicato.
L'account di Tristan complica anche la narrazione di OpenAI. Dice di aver inizialmente sentito che "molto poco input umano" era andato nel risultato, ma che durante le chiamate è emerso che un'intera squadra era stata coinvolta, che problemi più facili sono stati affrontati per primi e che persino il prompt mostrato a lui era stato generato tramite il prompting di Codex.
Ha accreditato il programma sottostante non a nessuna IA ma ai matematici Diego Córdoba e Luis Martínez-Zoroa, definendo il momento un punto di svolta "Deep Blue-Kasparov" per il campo.
Tristan non ha presentato alcuna causa. pone il pubblico del piano gratuito di ChatGPT a più di 1 miliardo di utenti attivi settimanali, e il modello pubblicitario è ciò che aiuta a mantenere in funzione la versione gratuita. mantiene che la sua prova differisce sostanzialmente da quella della coppia e che nessun dato utente è stato accesso per produrla.
Man mano che più ricerche vengono eseguite attraverso sistemi di IA di proprietà di aziende che costruiscono strumenti di ricerca rivali, la domanda più difficile non è chi possieda un'idea finita, ma cosa una piattaforma sia autorizzata a fare con ciò che viene digitato al suo interno e come chiunque potrebbe mai provare l'influenza dopo i fatti.
Se stai leggendo questo, sei già avanti. Resta così con la nostra newsletter.
Domande frequenti
Quale problema sostiene di aver risolto l'AI di OpenAI?
OpenAI afferma che un modello interno ha prodotto una dimostrazione, con formalizzazione in Lean, secondo cui le equazioni di Navier-Stokes per un fluido tridimensionale possono sviluppare una singolarità in tempo finito, uno dei sette Problemi del Premio Millennium dell'Istituto di Matematica Clay.
Perché i matematici accusano OpenAI di scorrettezza?
Tristan Buckmaster e il ricercatore di Anthropic Levent Alpöge avevano inserito lavori non pubblicati correlati in strumenti AI tra cui Codex di OpenAI; Buckmaster ha chiesto se OpenAI avesse accesso a quelle sessioni. L'azienda aveva proposto di attribuire il risultato senza il nome di Alpöge, cosa che Sebastien Bubeck nega.
OpenAI riceverà il premio da 1 milioni di dollari?
No. OpenAI afferma di non intendere richiedere il premio, e l'Instituto di Matematica Clay non ha riconosciuto il risultato, poiché le sue regole richiedono prima la pubblicazione, due anni di diffusione pubblica e un'accettazione generale.

Hannah Collymore
Hannah è una scrittrice e redattrice con quasi un decennio di esperienza nella scrittura di blog e nella copertura di eventi nel settore delle criptovalute. Presso Cryptopolitan, Hannah contribuisce alla pagina delle notizie, riportando e analizzando gli ultimi sviluppi nei settori DeFi, RWA, regolamentazione crypto, intelligenza artificiale e tecnologie emergenti. Si è laureata all'Arcadia University con una laurea in Amministrazione Aziendale.









