



- Anthropic は、Nintendo の Game Boy で動作する『ポケモン赤』を用いて、最新のカークラウド 3.7 Sonnet モデルのベンチマークを実施しました。
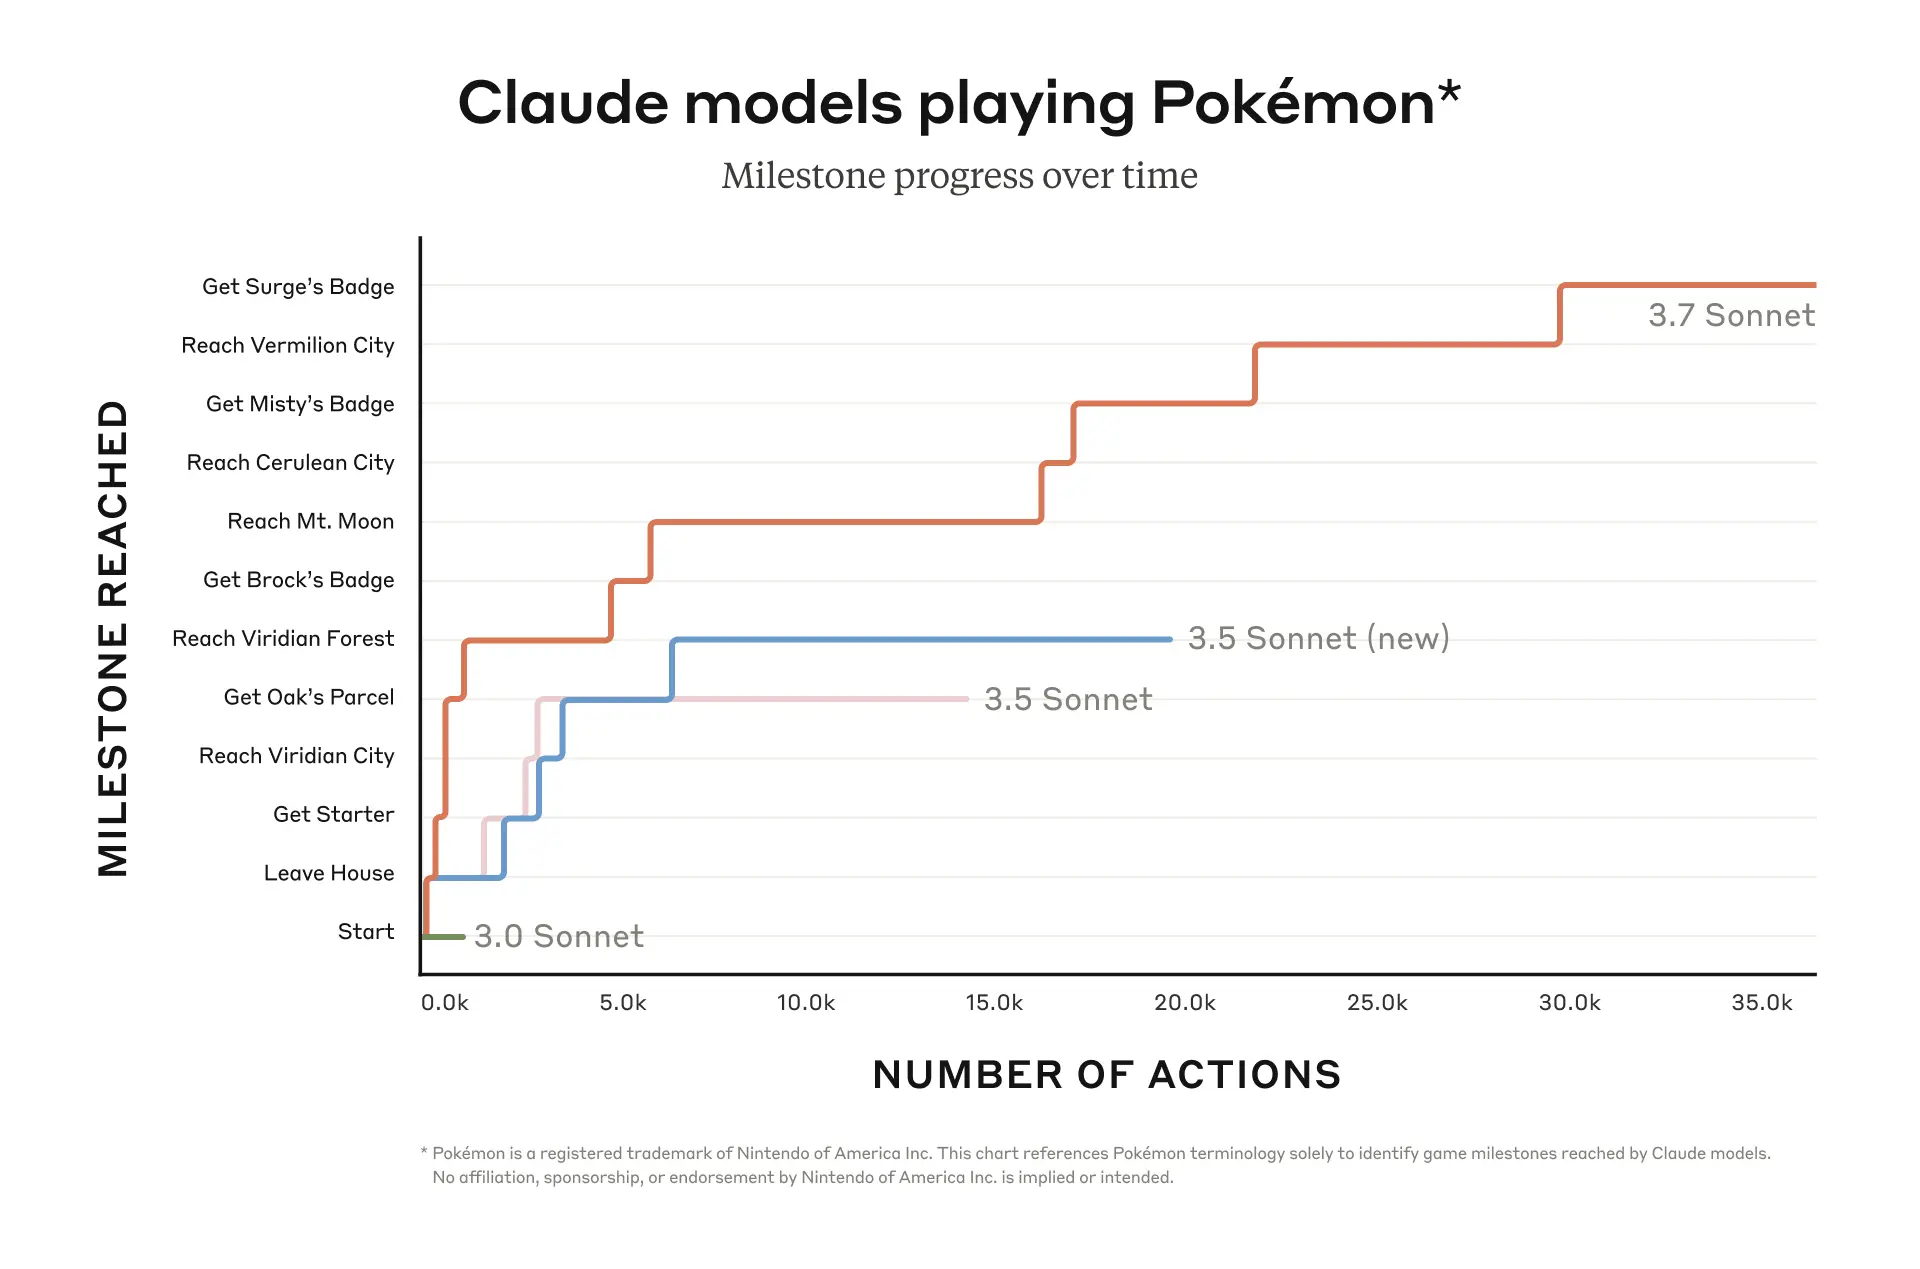
- このモデルはゲーム内で 12 のマイルストーンを達成し、35,000 回以上のアクションを実行しました。
- Claude 3.7 Sonnet は、問題の複雑さに応じて、ユーザーが望む限り「思考」を継続できます。
Anthropic は、任天堂のゲームボーイ上のクラシックゲーム『ポケモンレッド』で、最新の AI モデルである Claude 3.7 Sonnet をベンチマークした。このモデルは以前のバージョンと比較して大幅に優れたパフォーマンスを示し、ゲーム内で12のマイルストーンを達成した。
最近の ブログ投稿 で、Anthropic は最近のテストの詳細を明らかにした。同社は、Y軸にゲーム内の「マイルストーン」、X軸に「アクション数」を示すグラフを公開した。3.7 Sonnet を 3.5 Sonnet(新)、3.5 Sonnet、および 3.0 Sonnet と比較した。これらのモデルの中で、3.7 は明らかに優れたパフォーマンスを示し、合計12のマイルストーンを達成するために35,000回以上のアクションを実行した。ゲーム内のジムリーダー3人に勝利し、それぞれのバッジを獲得した。比較のために、Anthropic の以前のモデルである 3.0 Sonnet は、数千回のアクションしか実行できず、ゲームの開始段階をクリアできなかった。
最近のゲームプレイテストに関して、Anthropic は「ポケモンは Claude 3.7 Sonnet の能力を賞賛する楽しい方法ですが、これらの能力はゲームをプレイすることをはるかに超えた現実世界での影響を持つと期待しています」と述べた。
Claude 3.7 Sonnet のユニークな機能の一つは、「拡張思考」を行うことである。DeepSeek の R1 や OpenAI の o3-mini と同様に、Claude 3.7 Sonnet はより挑戦的な問題について推論を行うことができる。それはより多くの時間をかけ、その見返りにより多くの計算資源を使用する。
Claude 3.7 が前述のマイルストーンを達成するために消費した計算資源の量はまだ不明である。また、Anthropic は、モデルがゲーム内の最後のジムリーダーであるサージに到達するのにどのくらい時間がかかったかを明確にしていない。
ポケモンレッドでのテストは、新モデルの能力を示す軽い遊び心のある方法にすぎないと推測して安全だろう。それは、新モデルが拡張された推論能力を持ち、より複雑な問題を解決するために必要な時間(必要であれば)をかけることができることを示している。結局のところ、研究者たちは頻繁に、ストリートファイター、チェス、その他のビデオゲームをプレイさせることでモデルの能力をテストし始めてきた。
Claude 3.7 Sonnet はユーザーが望むだけ考えることができる
おそらく、Claude 3.7 Sonnet はユーザーが望むだけ考えることができる。それは「ハイブリッドAI推論モデル」として宣伝されており、リアルタイムの回答と深思熟慮された応答の両方を与える。ユーザーが推論機能をオンにするかどうかはユーザー次第であり、それにより Claude 3.7 Sonnet は問題により多くの時間または少ない時間を費やすことになる。
ここでの目標は、オプションを簡素化することでユーザー体験を向上させることのように見える。今日のほとんどのチャットボットには、一般ユーザーにとってかなり混乱を招くモデルピッカーがある。これらのモデルは通常、幅広い設定を持ち、能力が異なる。例えば、OpenAI の ChatGPT も幅広い提供を持っている。
実際、サム・アルトマンは最近、同社の 更新されたロードマップ で、OpenAI の長期的な目標は ChatGPT の提供を統一し、ユーザーが問題の解決策をその場で検索できるようにすることだと述べた。その意味で、ChatGPT もエージェント中心のアプローチを取る可能性がある。
Claude 3.7 Sonnet は DeepSeek R1 および o3-mini よりも高価である
Anthropic は月曜日に Claude 3.7 Sonnet を開発者とユーザーにリリースした。しかし、モデルの推論機能は、プレミアムチャットボットプランを選択した人のみに利用可能である。現時点では、入力トークン100万あたり3ドル、出力トークン100万あたり15ドルである。つまり、ユーザーは3ドルで75万語を入力できる。したがって、DeepSeek の R1 および ChatGPT の o3-mini よりも高価である。ただし、これら2つのモデルは Claude 3.7 Sonnet のようなハイブリッドではなく、非常に厳格な「推論モデル」である。
推論モデルは一般的に遅く動作し、質問に答えるのに時間がかかる。例としては、xAi の Grok 3 (Think)、Google の Gemini 2.0 Flash Thinking、DeepSeek の R1、そしてもちろん ChatGPT の o3-mini モデルがある。
Anthropic のプロダクトおよびリサーチリードであるダイアン・ペンによると、同社はユーザーが明示的に設定を選択するのではなく、Claude が問題についてどのくらい考えるかを決定できるようにしたいと考えている。これに関して、Anthropic はその ブログ投稿 で、「人間が、すぐに答えられる質問と思考を要する質問のために2つの別々の脳を持っていないのと同様に」と述べている。
しかし、xAi の Grok 3 のように、より制限が少なく議論にオープンになろうとするのではなく、Claude 3.7 Sonnet は特定の問題に答えることを拒否する。実際、今月初め、Grok 3 のベータ版はトランプに対して d*ath 刑を提案するほど進み、これは xAI のエンジニアリング責任者である Igor Babuschkin によって確認されたように、その後修正された「ひどく悪い失敗」と見なされた。

しかし、以前のモデルと比較して、拒否する頻度は低くなり、無害なプロンプトと有害なプロンプトの区別をつけることができる。Anthropic によると、不要な拒否は以前のモデルである Claude 3.5 Sonnet と比較して45%減少した。
暗号通貨のニュースを読むだけでなく、それを理解しましょう。ニュースレターに登録してください。無料です。
免責事項。 ここに提供される情報は取引助言ではありません。 Cryptopolitan.com 当社は、このページに提供される情報に基づいて行われたいかなる投資に対しても責任を負いません。いかなる投資判断を下す前に、独立した調査および/または資格を有する専門家への相談を強く推奨します。

シュマース・フマユーン
シュマスは元技術コンテンツライターであり、研究者です。









