


Anthropic hat sein neuestes KI-Modell Claude 3.7 Sonnet mit Pokémon Red benchmarkt
 Shummas Humayun
3 Min. Lesezeit

- Anthropic hat sein neuestes Modell Claude 3.7 Sonnet mit Pokémon Red auf dem Nintendo Game Boy benchmarkt.
- Das Modell erreichte 12 Meilensteine im Spiel und führte über 35.000 Aktionen aus.
- Claude 3.7 Sonnet kann „nachdenken
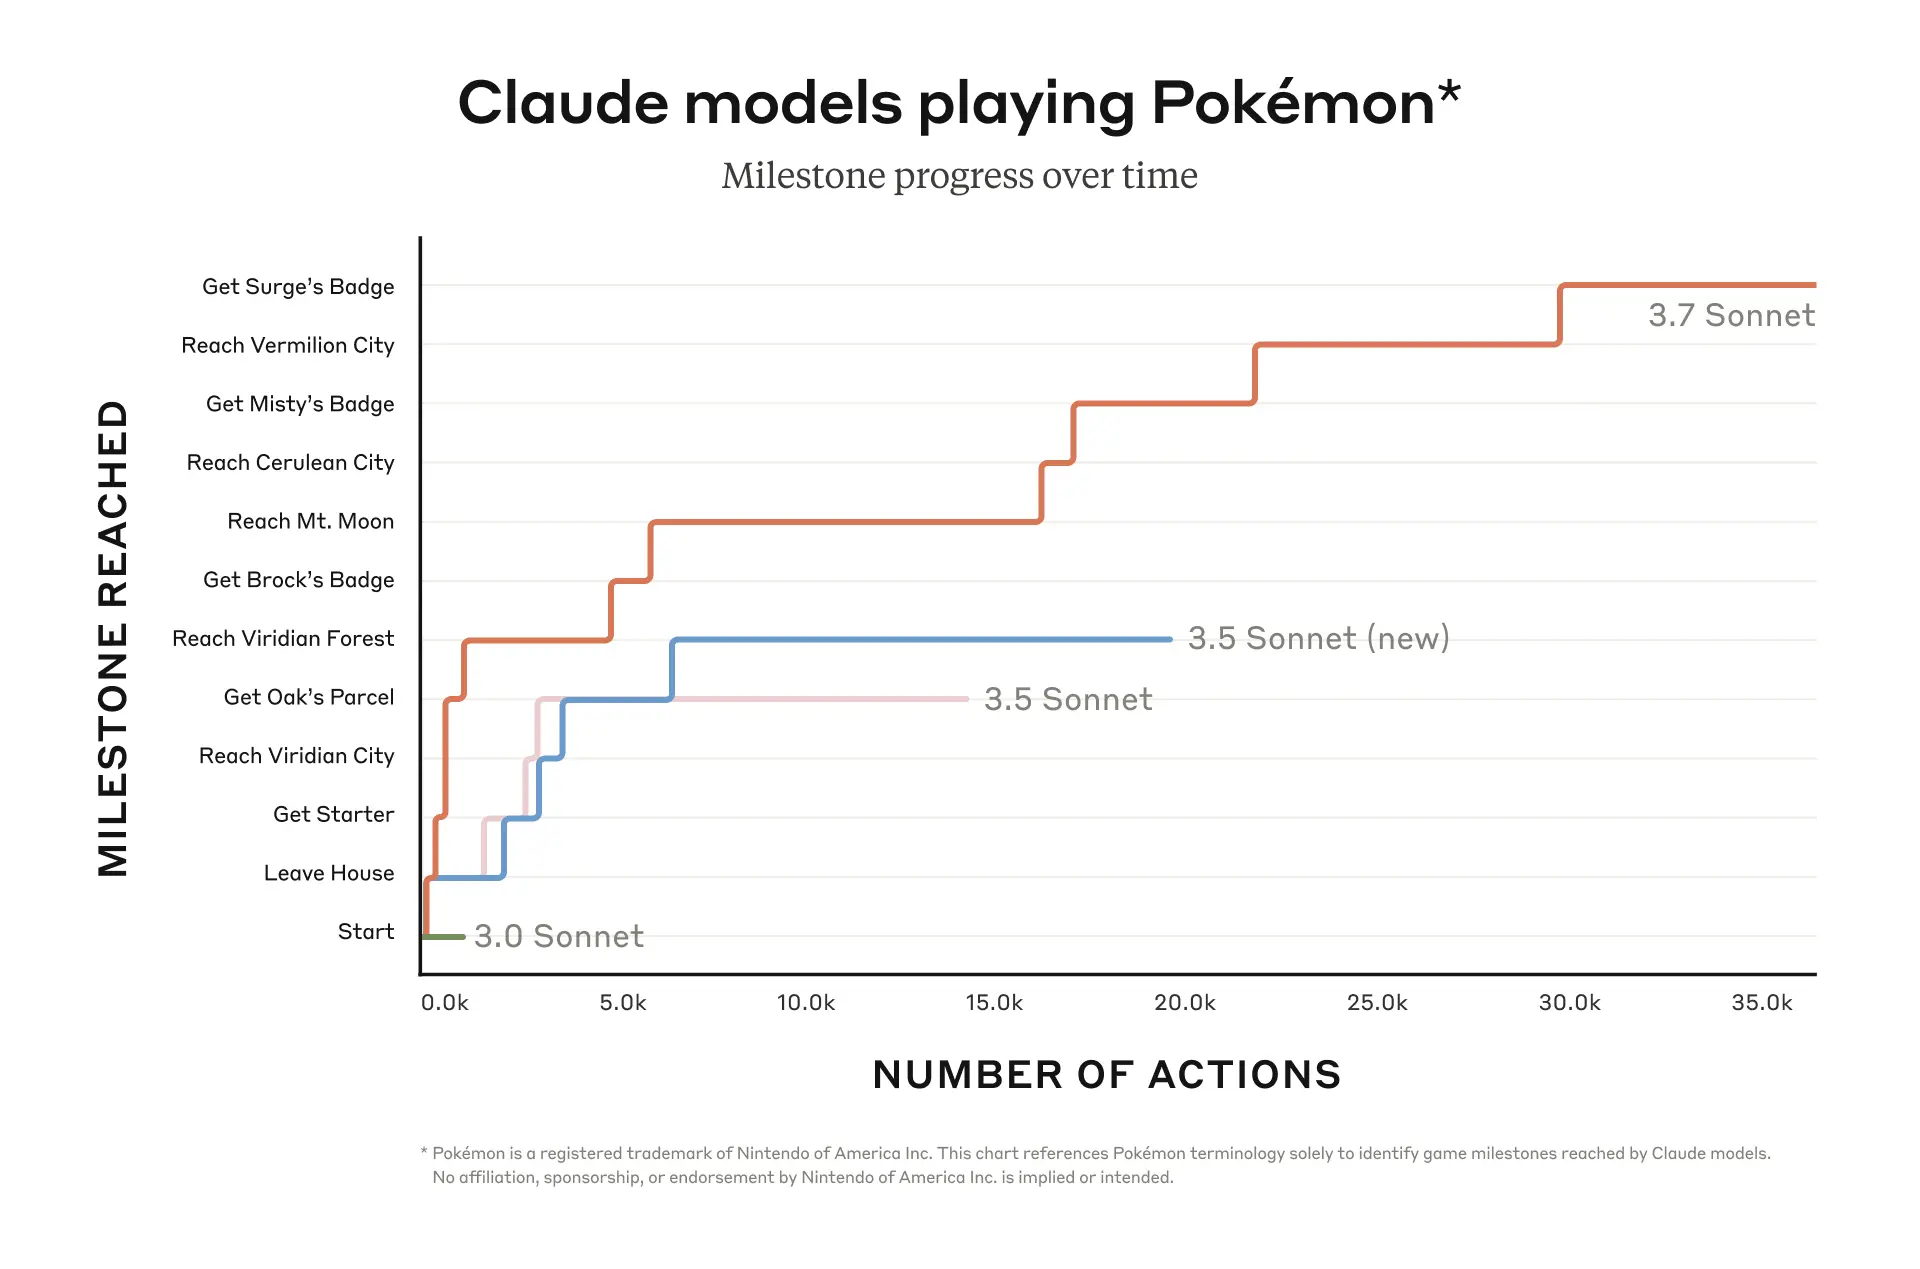
Anthropic hat sein neuestes KI-Modell, Claude 3.7 Sonnet, auf dem klassischen Spiel Pokémon Red auf dem Game Boy von Nintendo benchmarkt. Das Modell schnitt im Vergleich zu den vorherigen Versionen deutlich besser ab und schaffte es, 12 Meilensteine im Spiel zu erreichen.
In einem kürzlichen Blogbeitrag enthüllte Anthropic Details seiner jüngsten Tests. Das Unternehmen veröffentlichte ein Diagramm, das die im Spiel befindlichen „Meilensteine“ auf der Y-Achse und die „Anzahl der Aktionen“ auf der X-Achse zeigt. Es verglich die Leistung von 3.7 Sonnet mit 3.5 Sonnet (neu), 3.5 Sonnet und 3.0 Sonnet. Unter diesen Modellen schnitt 3.7 sichtbar besser ab, da es über 35.000 Aktionen ausführte, um insgesamt 12 Meilensteine zu erreichen. Es war erfolgreich gegen 3 Gym-Leader im Spiel und gewann die entsprechenden Abzeichen. Zum Vergleich: Anthropics früheres Modell, 3.0 Sonnet, konnte nur wenige tausend Aktionen ausführen und die Startstufen des Spiels nicht überschreiten.
Zu seinen jüngsten Gameplay-Tests bemerkte Anthropic: „Pokémon ist eine unterhaltsame Art, die Fähigkeiten von Claude 3.7 Sonnet zu schätzen, aber wir erwarten, dass diese Fähigkeiten weit über das Spielen von Spielen hinaus reale Auswirkungen haben.“
Ein einzigartiges Merkmal von Claude 3.7 Sonnet ist, dass es an „Extended Thinking“ (Erweitertes Denken) teilnimmt. Genau wie DeepSeek’s R1 und o3-mini von OpenAI ist Claude 3.7 Sonnet in der Lage, Probleme zu durchdenken, die anspruchsvoller sind. Es tut dies, indem es mehr Zeit in Anspruch nimmt und im Gegenzug mehr Rechenleistung verwendet.
Es ist noch nicht klar, wie viel Rechenleistung Claude 3.7 für die Erreichung der oben genannten Meilensteine verbraucht hat. Außerdem hat Anthropic nicht klar dargelegt, wie viel Zeit das Modell benötigte, um Surge, den letzten Gym-Leader im Spiel, zu erreichen.
Es ist sicher anzunehmen, dass die Tests von Pokémon Red nichts weiter als eine leichtgewichtige Art sind, die Fähigkeiten des neuen Modells zu präsentieren. Es zeigt einfach, dass das neue Modell zu erweitertem Schlussfolgern fähig ist und mehr Zeit in Anspruch nehmen kann (falls erforderlich), um komplexere Probleme zu lösen. Schließlich haben Forscher häufig begonnen, die Fähigkeiten ihrer Modelle zu testen, indem sie sie Videospiele wie Street Fighter, Schach und mehr spielen ließen.
Claude 3.7 Sonnet kann so lange denken, wie der Benutzer es möchte
Offensichtlich ist Claude 3.7 Sonnet in der Lage, so lange zu denken, wie der Benutzer es wünscht. Es wird als „hybrides KI-Schlussfolgerungsmodell“ beworben, da es Echtzeit-Antworten zusammen mit durchdachten Antworten liefert. Es liegt am Benutzer, ob er seine Schlussfolgerungsfähigkeiten aktiviert, was dazu führt, dass Claude 3.7 Sonnet mehr oder weniger Zeit für das Problem aufwendet.
Es scheint, als sei das Ziel hier, die Benutzererfahrung durch die Vereinfachung der Optionen zu verbessern. Die meisten Chatbots verfügen heute über einen Modellauswähler, der für den Durchschnittsnutzer eher verwirrend ist. Diese Modelle haben normalerweise eine Reihe von Einstellungen und variieren in ihren Fähigkeiten. Zum Beispiel hat auch OpenAI’s ChatGPT ein breites Angebot.
Tatsächlich erwähnte Sam Altman kürzlich in der aktualisierten Roadmap seines Unternehmens, dass das langfristige Ziel von OpenAI darin besteht, die Angebote von ChatGPT zu vereinheitlichen, sodass Nutzer unterwegs Lösungen für ihre Probleme suchen können. In diesem Sinne könnte ChatGPT auch einen agentenzentrierten Ansatz verfolgen.
Claude 3.7 Sonnet ist teurer als DeepSeek R1 und o3-mini
Anthropic hat Claude 3.7 Sonnet am Montag für Entwickler und Benutzer freigegeben. Die Schlussfolgerungsfunktionen des Modells sind jedoch nur für diejenigen verfügbar, die die Premium-Chatbot-Pläne auswählen. Derzeit kostet es nur 3 $ pro Million Eingabetokens und 15 $ pro Million Ausgabetokens. Das bedeutet, dass ein Benutzer 750.000 Wörter für 3 $ eingeben kann. Daher ist es teurer als sowohl R1 von DeepSeek als auch o3-mini von ChatGPT. Diese beiden Modelle sind jedoch keine Hybriden wie Claude 3.7 Sonnet; sie sind sehr strikt „Schlussfolgerungsmodelle“.
Schlussfolgerungsmodelle arbeiten im Allgemeinen langsamer und benötigen mehr Zeit, um eine Frage zu beantworten. Einige Beispiele sind xAi’s Grok 3 (Think), Google’s Gemini 2.0 Flash Thinking, R1 von DeepSeek und natürlich ChatGPT’s o3-mini-Modell.
Laut Dianne Penn, Product- und Research-Leiterin bei Anthropic, möchte das Unternehmen, dass Claude selbst entscheiden kann, wie lange es über ein Problem nachdenkt, anstatt dass Nutzer die Einstellungen explizit wählen müssen. In diesem Zusammenhang erklärte Anthropic in seinem Blogbeitrag: „Ähnlich wie Menschen nicht zwei separate Gehirne für Fragen haben, die sofort beantwortet werden können, versus solcher, die Nachdenken erfordern.“
Im Gegensatz zu xAi’s Grok 3, das weniger restriktiv sein und offener für Diskussionen stehen will, wird Claude 3.7 Sonnet bestimmte Fragen verweigern. Tatsächlich schlug die Beta-Version von Grok 3 Anfang dieses Monat sogar eine d*ath-Strafe für Trump vor, ein angeblich „schreckliches und schlechtes Versagen“, das seitdem korrigiert wurde, wie Igor Babuschkin, Leiter der Ingenieurabteilung bei xAI, bestätigte.

Im Vergleich zu seinen vorherigen Modellen verweigert es jedoch seltener Antworten und ist in der Lage, zwischen harmlosen und schädlichen Eingaben zu unterscheiden. Laut Anthropic wurden die unnötigen Verweigerungen im Vergleich zum vorherigen Modell, Claude 3.5 Sonnet, um 45 % reduziert.
Wenn Sie dies lesen, sind Sie bereits einen Schritt voraus. Bleiben Sie mit unserem Newsletter auf dem Laufenden.
Haftungsausschluss. Die bereitgestellten Informationen stellen keine Anlageberatung dar. Cryptopolitan.com Wir übernehmen keine Haftung für Investitionen, die auf den auf dieser Seite bereitgestellten Informationen basieren. Wir empfehlen dringend, vor jeglichen Anlageentscheidungen eine unabhängige Recherche durchzuführen und/oder einen qualifizierten Fachmann zu konsultieren.
Shummas Humayun
Shummas ist eine ehemalige technische Content-Autorin und Forscherin.









