






Peut-on faire confiance à la percée mathématique d'OpenAI ? Les mathématiciens s'indignent

- Le 8 septembre, OpenAI a annoncé qu'un système d'IA interne avait résolu le problème du prix Millennium de Navier-Stokes.
- Depuis, il a fait face à des accusations de la part des mathématiciens Tristan Buckmaster et Levent Alpöge selon lesquelles l'entreprise a précipité les travaux après avoir pris connaissance des leurs.
- L'entreprise nie avoir accédé à ces données tout en admettant ne pas pouvoir exclure que des données d'utilisation désidentifiées aient aidé à entraîner ses modèles.
OpenAI a affirmé avoir résolu la question de l'existence et de la régularité de Navier-Stokes, l'un des sept problèmes du prix Millennium déclarés par le Conseil consultatif scientifique de l'Institut de mathématiques Clay de Cambridge, dans le Massachusetts (CMI). Cependant, le problème le plus difficile à résoudre pourrait bien être de convaincre un public de plus en plus sceptique à l'égard des méthodes de ce géant de l'IA.
OpenAI est passé directement de la résolution d'un des problèmes mathématiques les plus difficiles non résolus de notre époque à la réponse aux questions de deux mathématiciens lui demandant si leur travail non publié avait d'une manière ou d'une autre aidé le laboratoire à parvenir à sa réponse.
Cependant, alors que ce drame se joue publiquement, OpenAI est à la traîne sur le plan de la perception, comme on pouvait s'y attendre lorsqu'un laboratoire d'IA évalué à un billion de dollars, impliqué dans une violation de sécurité par un agent rogue et un « réveil des consciences » interne concernant la gestion des risques s'oppose à deux universitaires attachants.
Quel problème mathématique OpenAI vient-il de résoudre ?
Le laboratoire d'IA dirigé par Sam Altman a déclaré avoir rédigé une preuve et une version vérifiable par machine dans le langage de preuve Lean qu'un fluide lisse, initialement calme, peut, sous une force lisse, accélérer sans limite et se briser en un temps fini.
Le travail, qu'OpenAI affirme avoir été réalisé par un modèle interne plus performant que son récent modèle GPT-6 Astra, résout l'un des sept problèmes d'un million de dollars que l'Institut de mathématiques Clay a listés en 2000.
Selon Mark Chen, responsable de la recherche, OpenAI a dépensé plus pour sa facture de calcul que le prix d'un million de dollars offert par le CMI. Sebastien Bubeck, un chercheur du laboratoire, a déclaré qu'environ 10 000 agents travaillaient sur le problème à un moment donné.
L'Institut Clay n'a pas encore reconnu la preuve d'OpenAI. L'institut exige que les solutions soient publiées dans une revue qualifiante, soient disponibles au public pendant deux ans et reçoivent une large acceptation de la part des mathématiciens avant d'être prises en considération pour le prix.
Il est à noter qu'OpenAI a déjà déclaré qu'il ne chercherait pas l'argent du prix.
OpenAI a-t-il utilisé le travail des mathématiciens dans leurs logs de chat ?
Le débat principal sur le travail d'OpenAI ne porte même pas sur les mathématiques. Le vrai drame concerne la question de savoir si les informations que Tristan Buckmaster de NYU et Levent Alpöge, un mathématicien employé par Anthropic, ont fournies aux modèles d'IA, y compris le Codex d'OpenAI, ont été détournées.
Tristan a directement demandé aux chercheurs du laboratoire si ses sessions et celles de Levent sur Codex étaient utilisées lorsqu'il a appris pour la première fois que le laboratoire d'IA avait dirigé une capacité de calcul majeure vers la résolution de l'énigme de Navier-Stokes.
Typique d'un mathématicien, Tristan s'est abstenu de formuler des accusations sans preuve, écrivant dans un déclaration publique que « je ne sais pas si nos données ont été utilisées ».
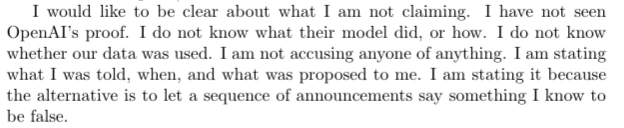
Cependant, le même document accusait OpenAI de soulever des « propositions » qui comprenaient le retrait du nom de Levent d'une annonce attribuant la solution au modèle interne d'OpenAI.
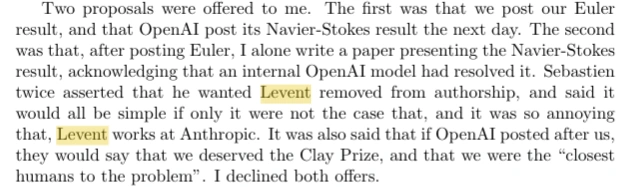
Bubeck a depuis démenti cette affirmation, écrivant sur X : « Je n'ai jamais demandé que Levent soit retiré de l'auteur de son propre travail », a-t-il écrit.
Je tiens à clarifier quelques points :
1) La capture d'écran montre que je contacte Levent pour coordonner nos publications. J'espère qu'il est clair, à la lecture du message, que nous sommes intervenus avec les meilleures intentions possibles.
2) Je n'ai jamais demandé que Levent soit retiré de l'auteur de son propre travail… pic.twitter.com/yRli0hLNuM
— Sebastien Bubeck (@SebastienBubeck) Septembre 8, 2026
Sam Altman s'est également exprimé pour soutenir son équipe.
« Peu probable mais pas impossible » n'est pas une dénégation assez forte pour les sceptiques
La défense principale d'OpenAI est catégorique : ni son personnel ni ses agents n'ont vu les invites, les brouillons ou les données utilisateur de la paire, et ils n'ont rencontré le travail que lorsqu'il est devenu public.
Pourtant, dans son propre article de blog, l'entreprise a ajouté une ligne que Levent lui-même a signalée: « Bien que peu probable, nous ne pouvons pas exclure que des données désidentifiées dérivées de leur utilisation de nos produits aient contribué à améliorer nos modèles. »
« je veux dire, chapeau à eux pour avoir été francs », Levent a posté.
Le compte de Tristan complique également le récit d'OpenAI. Il dit avoir été initialement informé que « très peu d'apport humain » était entré dans le résultat, mais que lors des appels, il est apparu qu'une équipe entière avait été impliquée, que des problèmes plus faciles avaient été traités en premier, et que même l'invite qui lui avait été montrée avait elle-même été générée en invitant Codex.
Il a crédité le programme sous-jacent non pas à une IA mais aux mathématiciens Diego Córdoba et Luis Martínez-Zoroa, qualifiant le moment d'un tournant « Deep Blue-Kasparov » pour le domaine.
Tristan n'a intenté aucun procès. OpenAI maintient que sa preuve diffère substantiellement de celle de la paire et qu'aucune donnée utilisateur n'a été consultée pour la produire.
À mesure que davantage de recherches sont effectuées via des systèmes d'IA appartenant à des entreprises développant des outils de recherche rivaux, la question la plus difficile n'est pas de savoir qui possède une idée achevée, mais ce qu'une plateforme a le droit de faire avec ce qui y est tapé, et comment quiconque pourrait jamais prouver une influence a posteriori.
Ne vous contentez pas de lire les actualités crypto. Comprenez-les. Abonnez-vous à notre newsletter. C'est gratuit.
FAQ
Quel problème OpenAI prétend-il avoir résolu avec son IA ?
OpenAI affirme qu'un modèle interne a produit une preuve, avec une formalisation en Lean, selon laquelle les équations de Navier-Stokes pour un fluide tridimensionnel peuvent développer une singularité en un temps fini, l'un des sept problèmes du prix Millennium de l'Institut Clay de Mathématiques.
Pourquoi des mathématiciens accusent-ils OpenAI d'impropriété ?
Tristan Buckmaster et le chercheur chez Anthropic, Levent Alpöge, avaient soumis un travail non publié connexe à des outils d'IA, dont Codex d'OpenAI ; Buckmaster a interrogé sur l'accès potentiel d'OpenAI à ces sessions. OpenAI a proposé de créditer le résultat sans le nom d'Alpöge, ce que Sebastien Bubeck nie.
OpenAI recevra-t-il le prix de 1 millions de dollars ?
Non. OpenAI indique ne pas avoir l'intention de revendiquer le prix, et l'Institut de mathématiques Clay n'a pas reconnu ce résultat, car ses règles exigent d'abord une publication, deux années de mise à disposition du public et une acceptation générale.

Hannah Collymore
Hannah est rédactrice et éditrice avec près de dix ans d'expérience dans la rédaction de blogs et le reporting d'événements dans l'espace crypto. Chez Cryptopolitan, Hannah contribue à la page actualités, en rapportant et en analysant les derniers développements dans les secteurs de la DeFi, des RWA, de la régulation des crypto-monnaies, de l'IA et des technologies de pointe. Elle est diplômée de l'Université Arcadia avec un diplôme en administration des affaires.









