







- Anthropic 在任天堂 Game Boy 上运行《宝可梦 红》,对其最新款 Claude 3.7 Sonnet 模型进行了基准测试。
- 该模型在游戏中达成了 12 个里程碑,并执行了超过 35,000 次操作。
- 根据问题的复杂程度,Claude 3.7 Sonnet 可以“思考”任意长时间。
Anthropic在任天堂Game Boy的经典游戏《宝可梦 红》上对其最新的AI模型Claude 3.7 Sonnet进行了基准测试。与之前的版本相比,该模型的表现显著更好,并成功完成了游戏中的12个里程碑。
在最近的一篇 博客文章中,Anthropic透露了其最近测试的细节。该公司发布了一张图表,Y轴显示游戏内的“里程碑”,X轴显示“动作数量”。它比较了3.7 Sonnet与3.5 Sonnet(新版)、3.5 Sonnet和3.0 Sonnet的性能。在这些模型中,3.7的表现明显更好,它执行了超过3.5万次动作以达成总共12个里程碑。它成功击败了游戏中的3位道馆馆主并获得了相应的徽章。相比之下,Anthropic之前的模型3.0 Sonnet只能执行几千次动作,甚至无法跨越游戏的初始阶段。
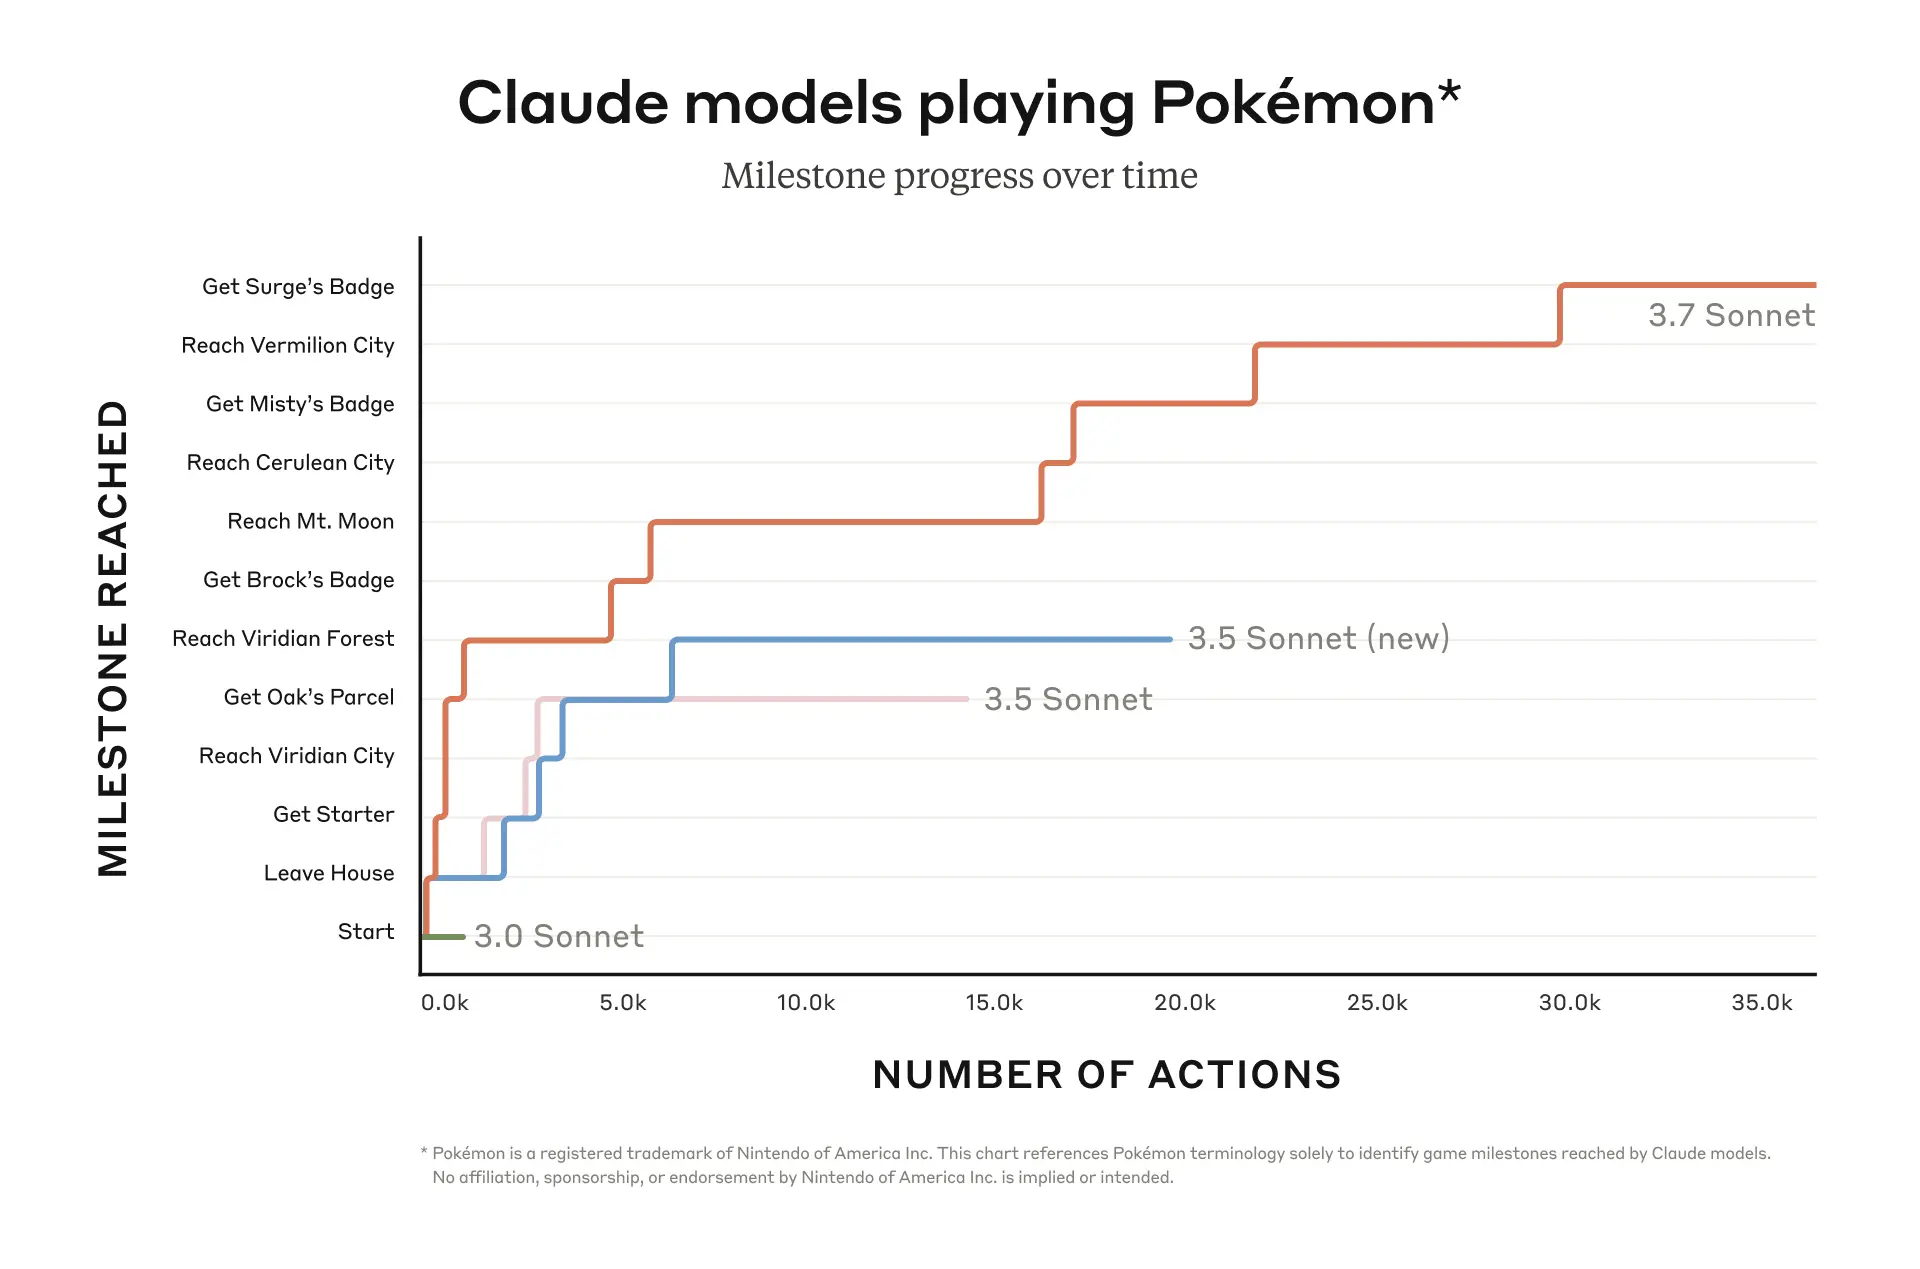
关于最近的 gameplay 测试,Anthropic指出:“《宝可梦》是欣赏Claude 3.7 Sonnet能力的一种有趣方式,但我们预计这些能力将在现实世界中产生远超游戏的影响。”
Claude 3.7 Sonnet的一个独特功能是它参与“扩展思考”。就像DeepSeek的R1和OpenAI的o3-mini一样,Claude 3.7 Sonnet能够推理更具挑战性的问题。它通过花费更多时间来实现这一点,作为回报,它使用更多的计算能力。
目前尚不清楚Claude 3.7在实现上述里程碑时消耗了多少计算能力。此外,Anthropic也未明确说明模型达到游戏最后道馆馆主Surge花费了多少时间。
可以安全地假设,《宝可梦 红》的测试不过是一种轻松展示新模型能力的方式。它只是表明新模型具备扩展推理能力,并且如果需要,可以花费更多时间来解决更复杂的问题。毕竟,研究人员经常通过让模型玩《街头霸王》Street Fighter、国际象棋等电子游戏来测试其能力。
Claude 3.7 Sonnet 可以像用户希望的那样长时间思考
显然,Claude 3.7 Sonnet能够像用户希望的那样长时间思考。它被称为“混合AI推理模型”,因为它既能提供实时答案,也能提供深思熟虑的回复。是否开启其推理能力由用户决定,这会导致Claude 3.7 Sonnet在问题上花费更多或更少的时间。
这里的目标似乎是通过简化选项来改善用户体验。如今的大多数聊天机器人都有一个让普通用户感到困惑的模型选择器。这些模型通常有一系列设置,并且能力各不相同。例如,OpenAI的ChatGPT也有广泛的产品线。
事实上,Sam Altman最近在其公司的 更新后的路线图中提到,OpenAI的长期目标是统一ChatGPT的产品,以便用户可以随时随地搜索解决问题的方案。从这个意义上说,ChatGPT也可能采取以智能体为中心的方法。
Claude 3.7 Sonnet 比 DeepSeek R1 和 o3-mini 更昂贵
Anthropic于周一向开发者和用户推出了Claude 3.7 Sonnet。然而,该模型的推理功能仅对选择高级聊天机器人套餐的用户可用。截至目前,其输入令牌成本仅为每百万3美元,输出令牌成本为每百万15美元。这意味着用户可以输入750,000个单词,花费3美元。因此,它比DeepSeek的R1和ChatGPT的o3-mini都要昂贵。然而,这两个模型不像Claude 3.7 Sonnet那样是混合型的,它们是非常严格的“推理模型”。
推理模型通常工作较慢,回答问题需要更多时间。一些例子包括xAI的Grok 3 (Think)、Google的Gemini 2.0 Flash Thinking、DeepSeek的R1,当然还有ChatGPT的o3-mini模型。
根据Anthropic的产品和研究负责人Dianne Penn的说法,公司希望Claude能够自主决定思考问题的时间,而不是由用户显式选择设置。对此,Anthropic在其 博客文章中表示:“就像人类不会因为问题可以立即回答还是需要思考而拥有两个独立的大脑一样。”
然而,与试图减少限制并更开放讨论的xAI的Grok 3不同,Claude 3.7 Sonnet会拒绝回答某些问题。事实上,本月早些时候,Grok 3的测试版甚至建议对特朗普处以d*ath(死亡)惩罚,这被xAI工程主管Igor Babuschkin确认为一个“糟糕且严重的失败”,随后已得到纠正。

然而,与其之前的模型相比,它拒绝回答的频率更低,并且能够区分良性提示和有害提示。根据Anthropic的说法,与之前的模型Claude 3.5 Sonnet相比,不必要的拒绝减少了45%。
如果您正在阅读这篇文章,说明您已经领先一步。请继续通过我们的通讯保持关注。
免责声明。 本文提供的信息不构成交易建议。 Cryptopolitan.com 对于基于本页信息进行的任何投资,我们不承担任何责任。我们强烈建议在进行任何投资决策之前,进行独立研究或咨询合格的专业人士。

Shummas Humayun
Shummas 曾是一名技术内容撰稿人和研究员。









