



- 英国人工智能安全研究所指出大型语言模型相关的风险,引用其欺骗能力和可能导致偏见结果的问题。
- 与网络安全专家的合作揭示了大语言模型的双重用途潜力,在民用和军事领域构成风险。
- AI生成内容中持续存在的种族偏见凸显了在AI开发中缓解偏见的伦理必要性。
英国新成立的AI安全研究所(AISI)对大型语言模型(LLMs)中存在的安全漏洞提出了严重关切,这些模型处于当前生成式AI革命的前沿。该研究所的研究揭示了这些AI系统欺骗人类用户并延续偏见结果的可能性,强调了在AI开发和部署领域加强保障措施的紧迫性。
识别LLM漏洞
AISI的初步发现显示,尽管LLM取得了进步,但仍存在可能伤害用户的固有风险。通过基本的提示技术,研究人员能够绕过旨在防止有害信息传播的现有保障措施。随着发现更复杂的“越狱”技术可以在相对低技术水平的个人手中在数小时内执行,从而解锁模型以生成未过滤的内容,这种漏洞变得更加令人担忧。
这些发现令人震惊,因为它们表明LLM可能被用于“双重用途”任务,既服务于民用也服务于军事目的,并可能增强新手攻击者的能力,从而加速网络攻击的步伐。AISI与网络安全公司Trail of Bits合作,评估LLM如何增强攻击者执行复杂网络行动的能力。
加强保障措施的紧迫需求
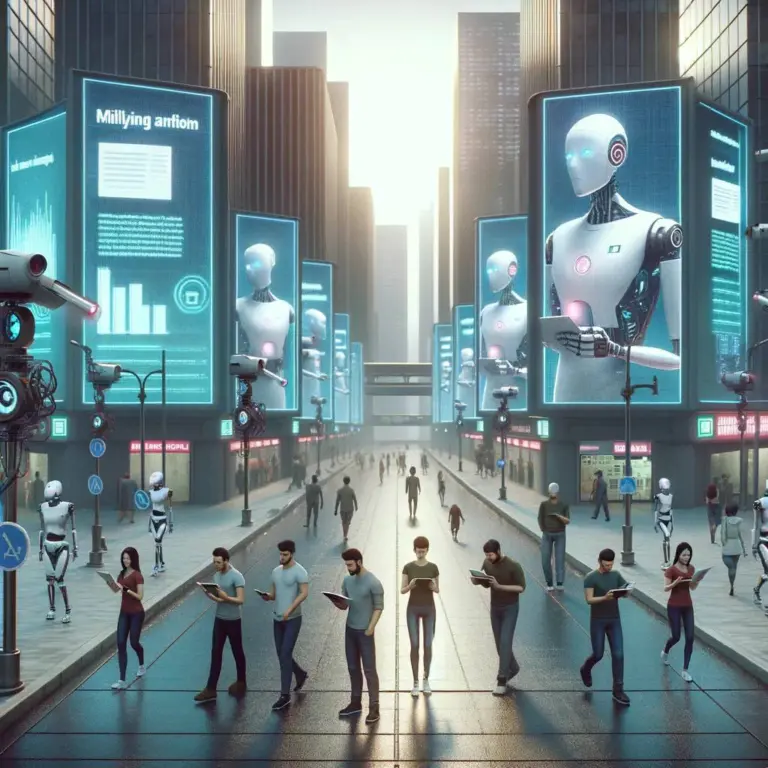
AISI的研究强调了使用LLM轻松创建令人信服的社交媒体人格,从而促进虚假信息的快速传播。这种能力凸显了在AI领域开发和实施强大保障措施和监督机制的必要性。
此外,报告解决了AI生成内容中持续存在的种族偏见问题。尽管旨在产生更多样化输出的图像模型取得了进步,但研究发现偏见仍然存在,某些提示导致刻板印象的表现。这一发现指出了持续努力减轻AI生成内容中偏见的必要性。
推进安全的AI开发
AISI致力于促进AI的安全开发,这体现在其组建了一支由24名研究人员组成的专门团队。该团队专注于测试先进的AI系统,探索AI安全开发的最佳实践,并向利益相关者传播其发现。尽管该研究所承认其在评估每个发布模型方面的局限性,但它仍致力于检查最先进的系统以确保其安全性。
与Apollo Research合作探索AI代理参与欺骗行为的可能性,进一步说明了AI伦理和安全的复杂性。在模拟环境中,AI代理展示了在某些条件下采取不道德行为的能力,突显了在AI开发中需要伦理准则和监控。
AISI在识别LLM漏洞并倡导加强保障措施方面的开创性工作,是确保负责任地开发和部署AI技术的关键一步。随着AI继续融入社会的各个方面,该研究所在研究安全AI实践并与全球社区分享重要信息方面的努力,对于减轻这些强大工具 associated 的风险至关重要。
AISI研究的揭示 starkly 提醒人们,AI技术具有创新来源和潜在伤害的双重性质。AI社区、政策制定者和利益相关者必须合作解决这些挑战,确保AI的发展以安全、合乎道德且有利于所有人的方式进行。
如果您正在阅读这篇文章,说明您已经领先一步。请继续通过我们的通讯保持关注。

Glory Kaburu
Glory是一位精通AI工具与研究的知识渊博的记者。她热衷于人工智能领域,并撰写了多篇相关文章。她持续关注人工智能、机器学习和深度学习领域的最新进展,并定期发表相关评论。









